



SLA (Service Level Agreement) to umowa lub część umowy określająca zasady utrzymania systemu oraz poziom usług gwarantowany przez dostawcę. Skuteczny dokument wskazuje czasy reakcji na zgłoszenie i przywrócenia działania, dostępność, priorytety awarii, godziny wsparcia oraz odpowiedzialność stron. Dzięki temu firma wie, czego może oczekiwać, gdy system przestanie działać.
Znaczenie tych ustaleń rośnie po starcie produkcyjnym. System zaczyna obsługiwać sprzedaż, finanse, magazyn, produkcję lub raportowanie, więc awaria może zatrzymać konkretny proces biznesowy. Dlatego umowa SLA powinna wynikać z rzeczywistego znaczenia rozwiązania dla organizacji, a nie z uniwersalnego szablonu.
Czym jest SLA (Service Level Agreement) i dlaczego jest kluczowe po wdrożeniu systemu
Umowa o poziomie świadczenia usług porządkuje zasady współpracy na wypadek awarii: określa, kto obsługuje zgłoszenie, kiedy dostępne jest wsparcie, jak szybko rozpocznie się diagnostyka i w jakim terminie powinna zostać przywrócona usługa. Właśnie temu służą umowy SLA IT. Co to oznacza dla firmy? Przede wszystkim przewidywalność i możliwość rozliczenia dostawcy z mierzalnych zobowiązań.
Po zakończeniu wdrożenia aktywny zespół projektowy zwykle zastępują helpdesk, kolejki zgłoszeń i procedury eskalacji. W przypadku rozwiązań klasy ERP trzeba jednak patrzeć szerzej niż na dostępność aplikacji. Niedziałająca integracja z bankiem, WMS, e-commerce lub operatorem logistycznym może zatrzymać proces, mimo że główny system ERP pozostaje dostępny. Poziom ochrony należy więc wiązać z procesami, a nie wyłącznie z komponentami technicznymi.
SLA, SLO i KPI - czym różnią się te pojęcia w utrzymaniu IT?
SLA opisuje zobowiązanie dostawcy usług wobec klienta, np. podjęcie incydentu krytycznego w ciągu 30 minut.
SLO (Service Level Objective) to konkretny cel poziomu usługi, np. dostępność 99,9% w miesiącu.
KPI (Key Performance Indicator) mierzy natomiast działanie usługi lub procesu, np. średni czas rozwiązania, odsetek zgłoszeń zamkniętych w terminie czy liczbę ponownie otwartych ticketów.
Rozróżnienie ma znaczenie praktyczne: nie każdy wskaźnik raportowy jest zobowiązaniem kontraktowym. Umowa powinna wskazywać, które parametry podlegają rozliczeniu, jak są mierzone i skąd pochodzą dane. Rosnąca liczba podobnych incydentów może wymagać analizy przyczyny źródłowej, zmiany konfiguracji albo dodatkowego doradztwa, nawet jeżeli formalne czasy reakcji są zachowane.
 Treść wygenerowana przez AI
Kluczowe parametry w umowie SLA: czas reakcji, czas naprawy (MTTR) i dostępność (Uptime)
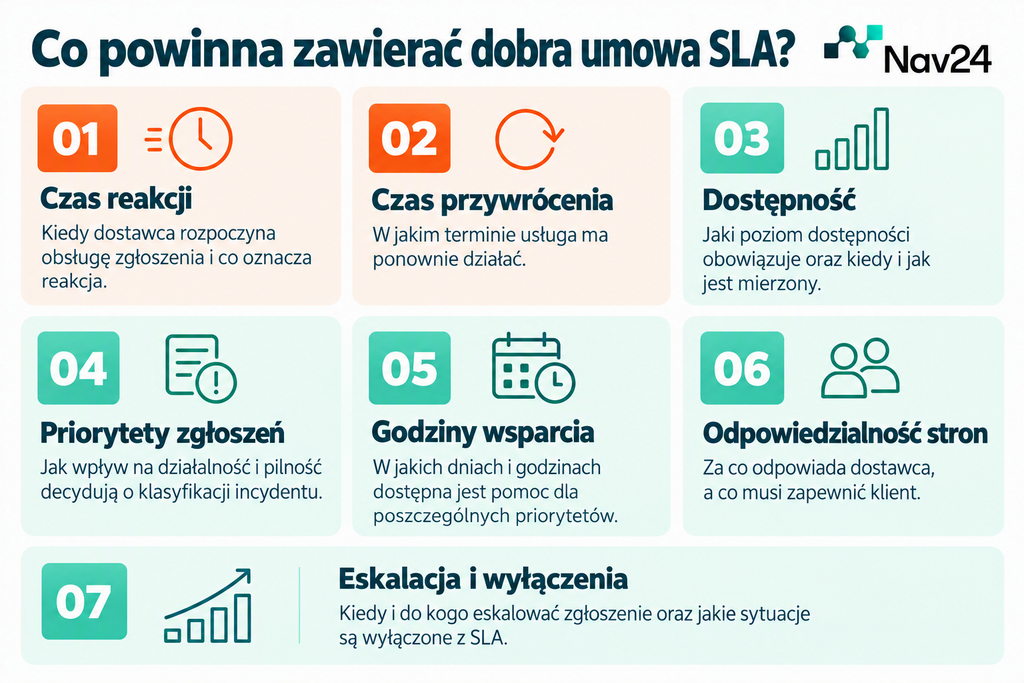
Najczęstsza niejasność dotyczy czasu reakcji. Potwierdzenie przyjęcia zgłoszenia nie jest tym samym co rozpoczęcie diagnostyki, przedstawienie obejścia ani naprawa. Dlategowarunki SLA w IT powinny definiować oddzielnie czas reakcji, czas przywrócenia usługi oraz, jeśli to potrzebne, maksymalny czas rozwiązania problemu.
MTTR (Mean Time to Repair lub Mean Time to Restore) oznacza średni czas naprawy albo przywrócenia działania. Jest wskaźnikiem statystycznym, a nie gwarancją usunięcia każdego incydentu w identycznym terminie. Jeśli strony oczekują granicznego czasu dla priorytetu P1, powinny zapisać go osobno.
Dostępność również wymaga doprecyzowania. Dobrze skonstruowana umowa SLA powinna precyzyjnie określać godziny obowiązywania, punkty pomiarowe, planowane okna serwisowe oraz zasady dotyczące awarii usług zewnętrznych. Inaczej serwer może działać, choć krytyczny proces nadal jest niedostępny.
Jak zdefiniować priorytety zgłoszeń i poziomy krytyczności awarii
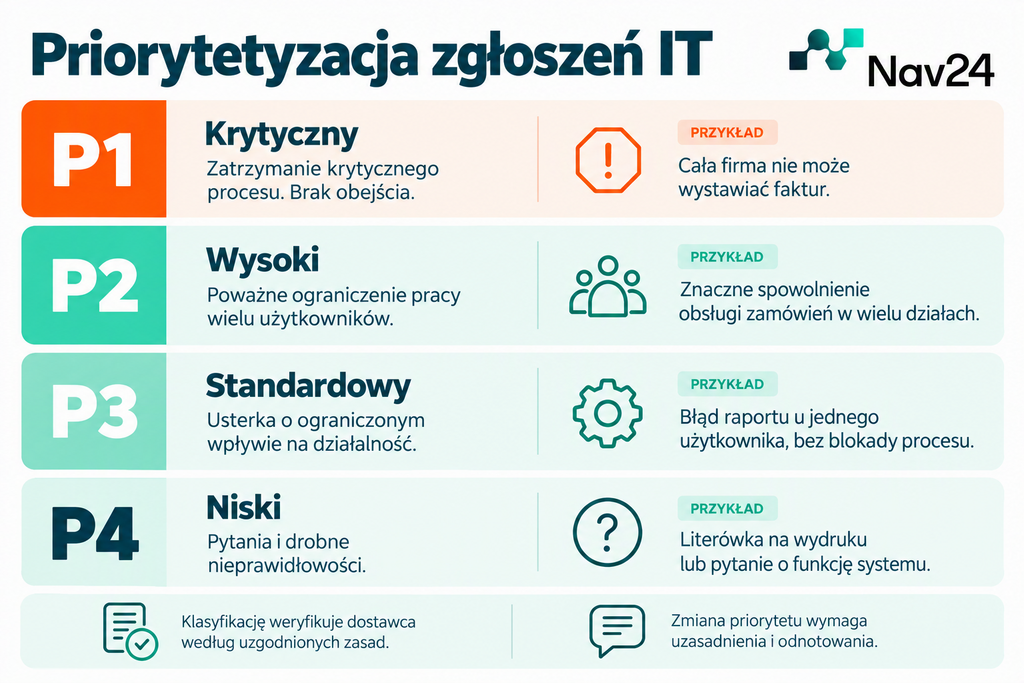
Literówka na wydruku i brak możliwości wystawienia faktury przez całą firmę nie powinny trafiać do tej samej kolejki. Można zastosować cztery poziomy dostępności, np.:
- P1 dla zatrzymania krytycznego procesu bez obejścia,
- P2 dla poważnego ograniczenia dotyczącego wielu użytkowników,
- P3 dla standardowych usterek o ograniczonym wpływie
- P4 dla pytań i drobnych nieprawidłowości.
Priorytetu nie powinien ustalać wyłącznie zgłaszający. Najlepiej połączyć dwa kryteria: wpływ na działalność i pilność. Incydent dotyczący jednej osoby może być uciążliwy, lecz zatrzymanie sprzedaży we wszystkich oddziałach ma inne konsekwencje. Dostawca powinien móc zweryfikować klasyfikację według uzgodnionej macierzy, a zmiana priorytetu powinna być uzasadniona i odnotowana.
 Treść wygenerowana przez AI
Podział odpowiedzialności - zakres wsparcia klienta a obowiązki dostawcy IT
SLA nie może być wyłącznie listą obowiązków serwisu. Dostawca odpowiada zwykle za przyjęcie i diagnostykę zgłoszeń, usuwanie usterek, eskalację do producenta, monitoring objętych usług oraz komunikację statusu. Klient zapewnia dostęp do środowiska, wskazuje osoby uprawnione, przekazuje dane potrzebne do diagnozy i współpracuje przy wdrożeniu rozwiązania.
Zgłoszenie „faktura nie działa” jest niewystarczające. Ticket powinien zawierać środowisko, rolę użytkownika, numer dokumentu lub procesu, treść komunikatu, czas wystąpienia i kroki pozwalające odtworzyć błąd. W umowie warto wskazać, kiedy bieg SLA zostaje wstrzymany, np. podczas oczekiwania na dostęp lub informacje od klienta.
Należy też odróżnić incydent od zmiany. Nowy raport, pole czy modyfikacja workflow powinny przejść przez odpowiednią procedurę, wycenę i akceptację. Większe modyfikacje łączą utrzymanie z obszarem takim jak zarządzanie projektami, ponieważ wymagają analizy, konfiguracji, testów i kontrolowanego wdrożenia.
Kary umowne, wyłączenia i audyt - jakie zapisy może zawierać umowa SLA
Umowa powinna wyjaśniać, jak mierzone są parametry i co następuje po ich niedotrzymaniu. Możliwe są kary umowne lub obniżenie opłaty za usługę, proporcjonalne do znaczenia naruszenia. Szczegółowe zapisy odpowiedzialności należy uzgodnić z osobami prowadzącymi kwestie prawne i kontraktowe.
Równie ważne są wyłączenia, np. awarie infrastruktury utrzymywanej przez klienta, działania podmiotów trzecich albo brak dostępu potrzebnego do diagnozy. Lista nie może być jednak tak szeroka, by SLA traciło znaczenie. Trzeba też opisać okna serwisowe, źródła danych i częstotliwość raportowania. System ticketowy, monitoring i logi powinny pozwalać obu stronom odtworzyć sposób wyliczenia wyniku.
Ile kosztuje SLA i jak dobrać odpowiedni pakiet wsparcia do potrzeb firmy
Cena zależy od godzin gotowości zespołu, wymaganych czasów reakcji, złożoności środowiska, liczby integracji i kompetencji potrzebnych do obsługi. Wsparcie w dni robocze 8:00-16:00 wycenia się inaczej niż dyżur 24/7 z reakcją na P1 w kilkanaście lub kilkadziesiąt minut.
Najwyższego pakietu nie warto kupować „na wszelki wypadek”. Najpierw trzeba oszacować koszt godziny przestoju, godziny pracy procesów i dopuszczalny czas niedostępności. Często optymalny jest model mieszany: incydenty krytyczne są obsługiwane całodobowo, a standardowe zgłoszenia w godzinach pracy. Warto też oddzielić abonament za gotowość i obsługę awarii od puli godzin na rozwój funkcjonalny.
Najczęstsze błędy przy zawieraniu umów SLA i jak ich uniknąć
Pierwszy błąd to kopiowanie parametrów z innych firm. Zakład trzyzmianowy potrzebuje innych warunków niż biuro pracujące od poniedziałku do piątku. Drugi błąd to mylenie czasu reakcji z czasem rozwiązania. Trzeci to brak jasnej klasyfikacji incydentów, przez który każde zgłoszenie staje się „krytyczne”.
Problemy powoduje również pomijanie zależności od chmury, integracji i usług zewnętrznych. Umowa musi wskazać granice odpowiedzialności oraz ścieżkę eskalacji. Nie wystarczy też podpisać dokumentu i odłożyć go do archiwum. Raporty należy regularnie przeglądać, analizując nie tylko odsetek zgłoszeń zamkniętych w terminie, ale również przyczyny powracających awarii.
Warunki wsparcia powinny być aktualizowane wraz z rozwojem organizacji. Nowe oddziały, moduły, kanały sprzedaży lub wydłużone godziny pracy mogą zmienić profil ryzyka. Dobrym rozwiązaniem jest przegląd SLA co najmniej raz w roku oraz po każdej istotnej zmianie architektury lub procesu biznesowego.
Podsumowanie
Dobra umowa SLA nie polega na wpisaniu najkrótszych możliwych terminów. Powinna chronić najważniejsze procesy w sposób proporcjonalny do skutków ich niedostępności. Dlatego prace warto rozpocząć od analizy biznesowej, a dopiero potem ustalać parametry techniczne.
Skuteczne SLA jest realistyczne, mierzalne i możliwe do egzekwowania. Definiuje priorytety, czasy reakcji i przywrócenia, dostępność, godziny wsparcia, obowiązki stron, wyłączenia oraz eskalację. Wtedy staje się praktycznym narzędziem ograniczania ryzyka, a nie tylko załącznikiem do umowy.
Najczęściej zadawane pytania
Co oznacza SLA w usługach IT?
SLA (Service Level Agreement) określa uzgodniony pomiędzy klientem a usługodawcą poziom świadczenia usług. Dokument może definiować między innymi godziny dostępności wsparcia, czasy reakcji i rozwiązania zgłoszeń, dostępność określonych usług, klasy incydentów oraz sposób eskalacji.
Czy SLA gwarantuje, że każda awaria zostanie natychmiast naprawiona?
Nie. SLA powinno rozróżniać między czasem reakcji, rozpoczęciem obsługi, przywróceniem działania oraz pełnym rozwiązaniem problemu. Spełnienie czasu reakcji nie musi więc oznaczać, że usterka zostanie usunięta w tym samym czasie.
Co oznacza dostępność na poziomie 99,9%?
W ujęciu 30-dniowego miesiąca 99,9% dostępności odpowiada około 43 minutom potencjalnej niedostępności. Rzeczywisty sposób kalkulacji zależy jednak od zapisów umowy, między innymi okresu pomiarowego, godzin świadczenia usługi i wyłączenia uzgodnionych przerw serwisowych.
Jak ustalić, które zgłoszenie powinno mieć najwyższy priorytet?
Najlepiej oceniać jednocześnie wpływ incydentu na biznes oraz jego pilność. Najwyższy priorytet powinien dotyczyć przede wszystkim zdarzeń zatrzymujących krytyczny proces lub powodujących szeroką niedostępność systemu, szczególnie gdy użytkownicy nie mają rozwiązania zastępczego.
Czy każda firma potrzebuje wsparcia SLA 24/7?
Nie. Całodobowe wsparcie ma uzasadnienie przede wszystkim wtedy, gdy krytyczne procesy przedsiębiorstwa faktycznie działają poza standardowymi godzinami pracy, a ich przestój generuje istotne straty lub ryzyko biznesowe. W innych przypadkach korzystniejszy ekonomicznie może być model obejmujący standardowe godziny wsparcia i dodatkową obsługę całodobową wyłącznie dla incydentów krytycznych.


